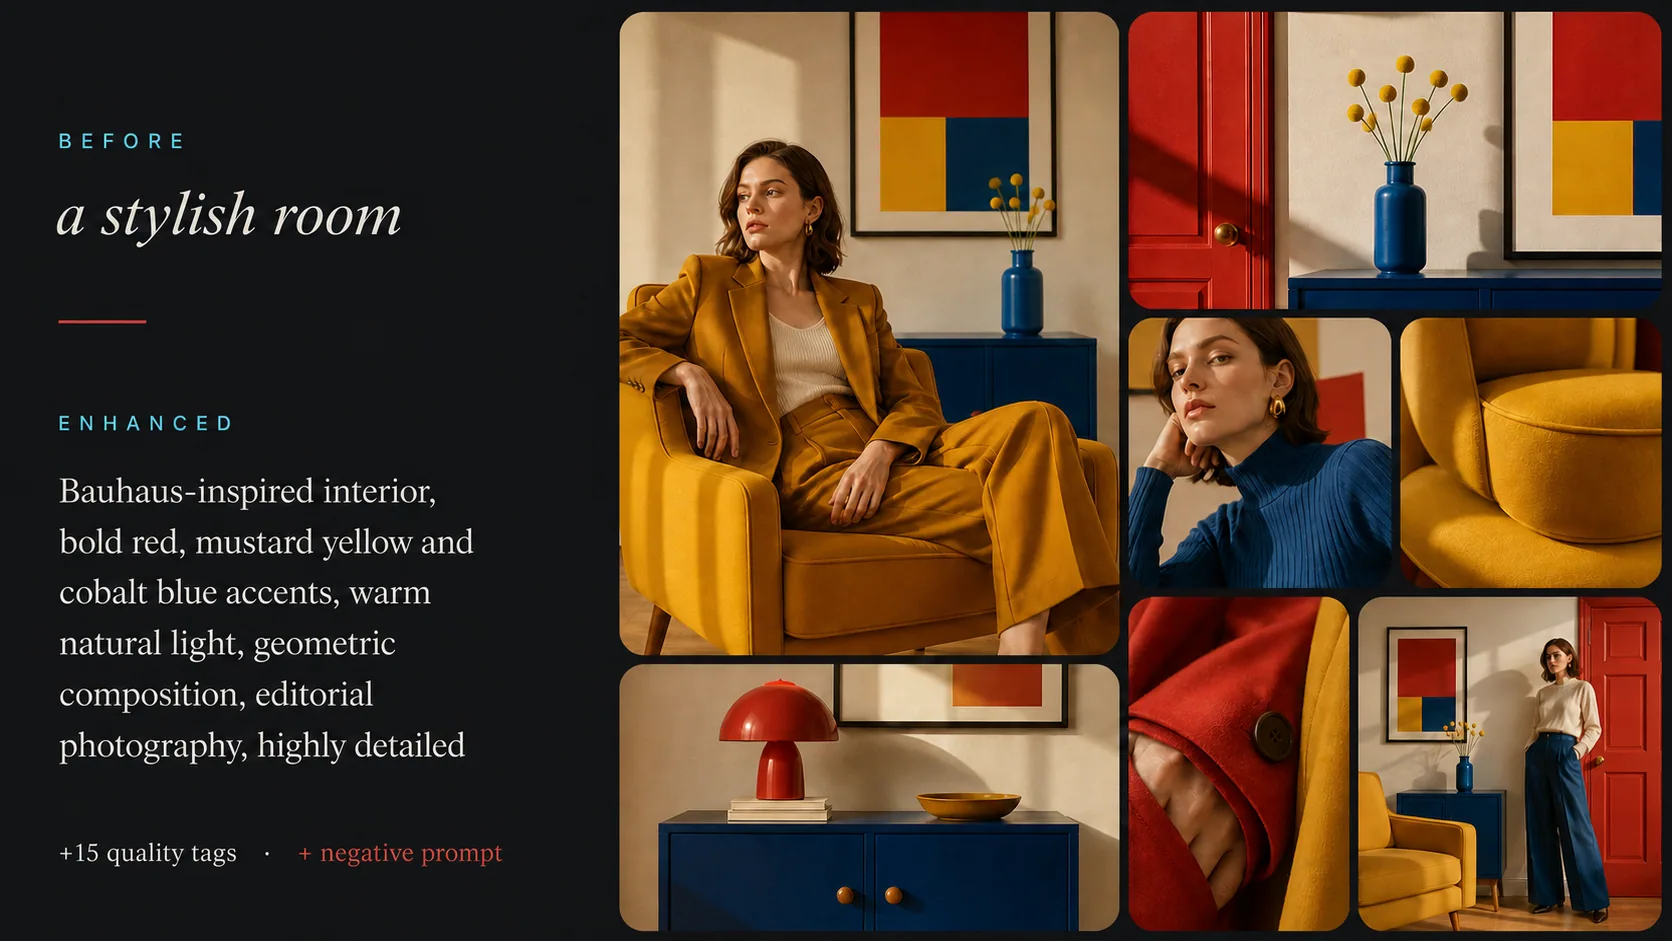
左邊是原圖,右邊是用反推出來的提示詞生成的。同一個工具,沒有修圖。
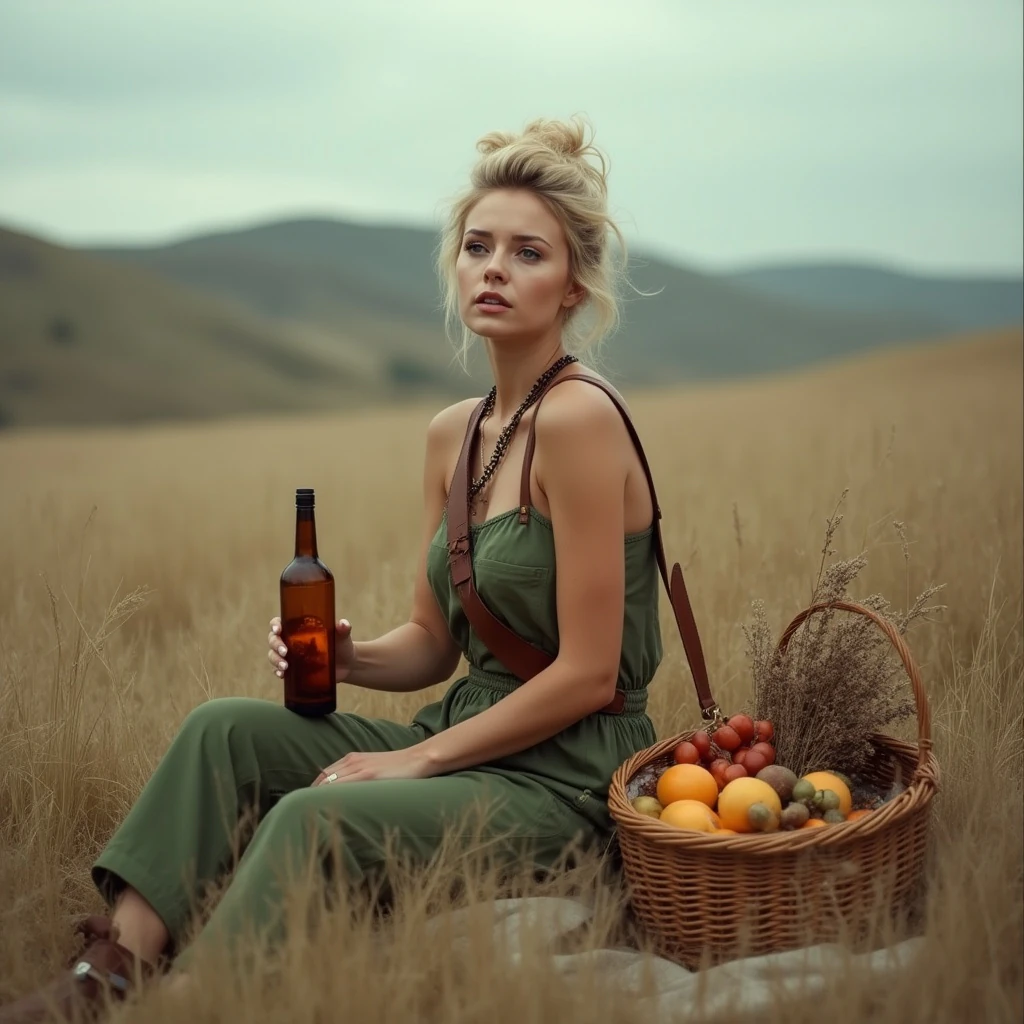
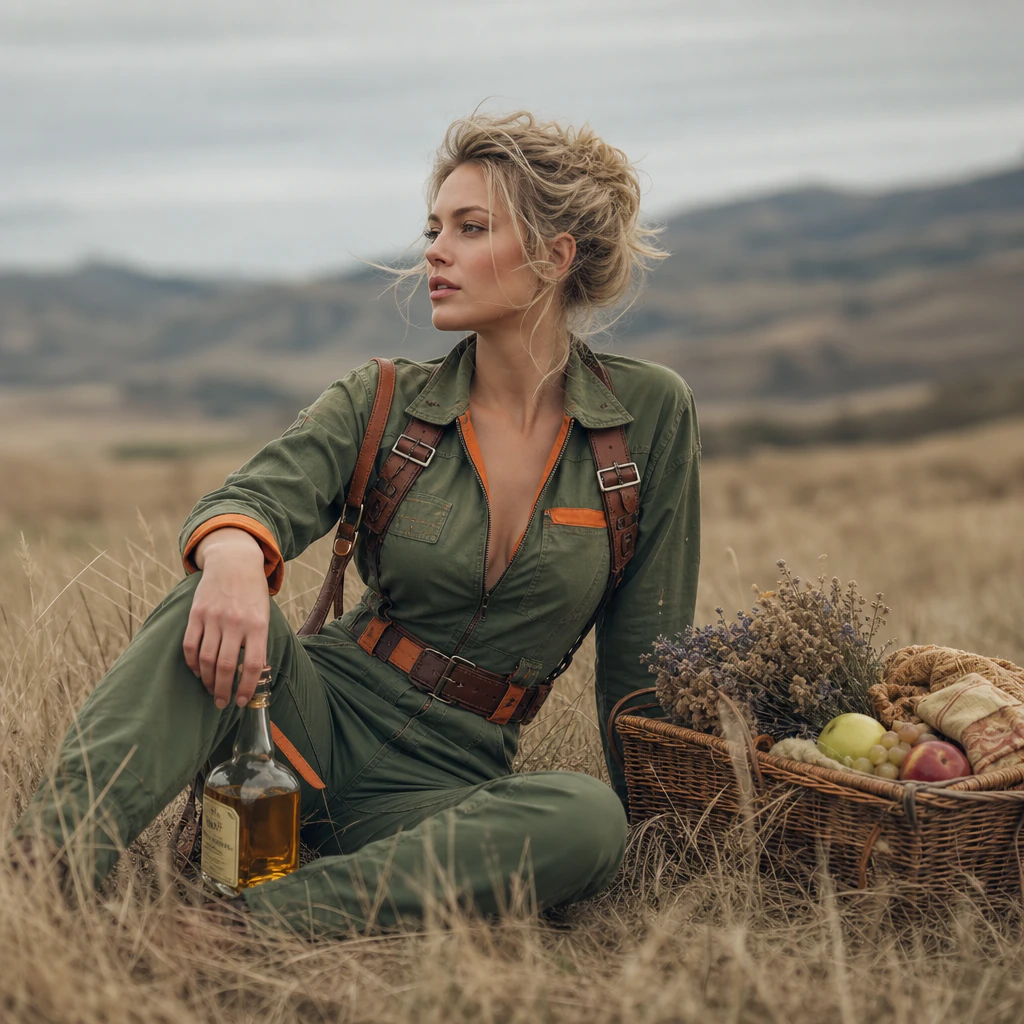
提示詞: A photorealistic portrait of a woman with blonde, windswept hair styled in an updo, wearing a green jumpsuit with orange accents and a brown leather harness. She is sitting in a field of tall, dry grass, holding a bottle of amber liquid in her right hand and looking off to the side with a thoughtful expression...
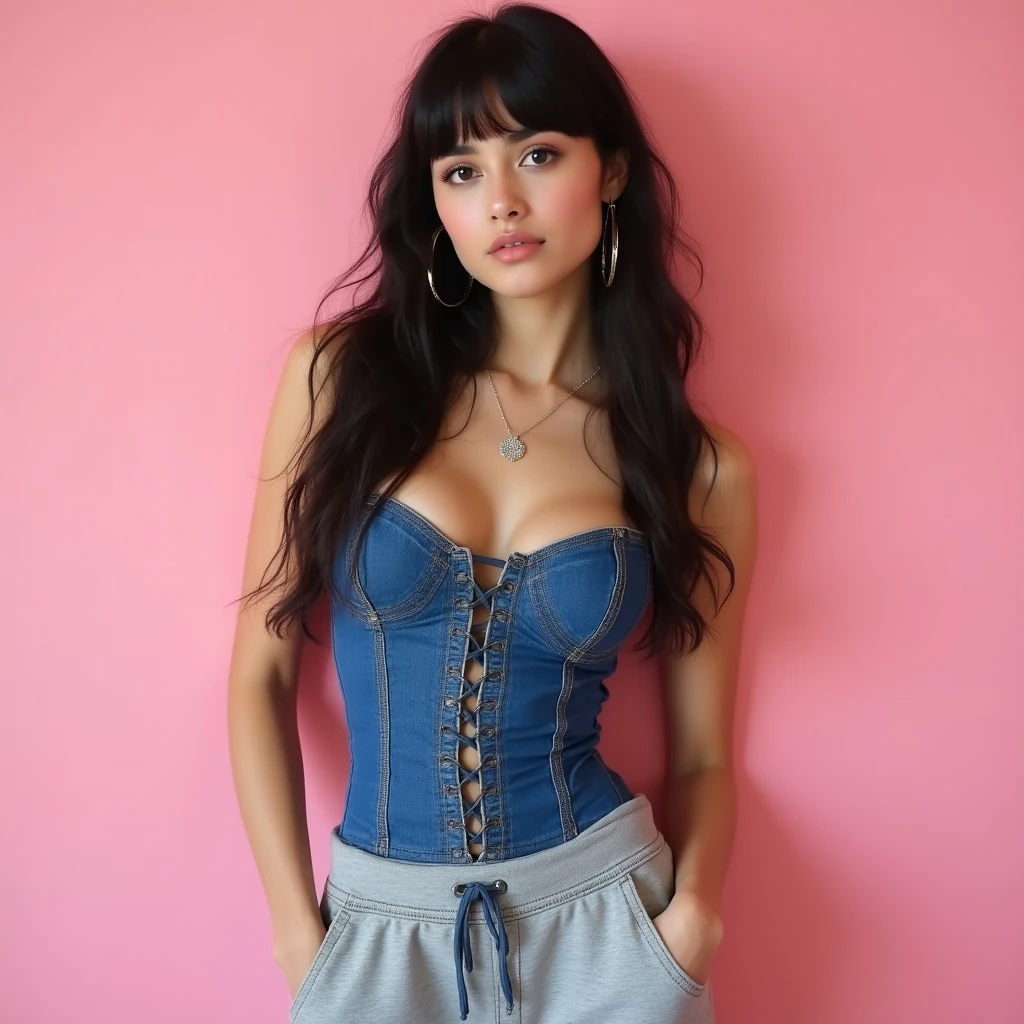
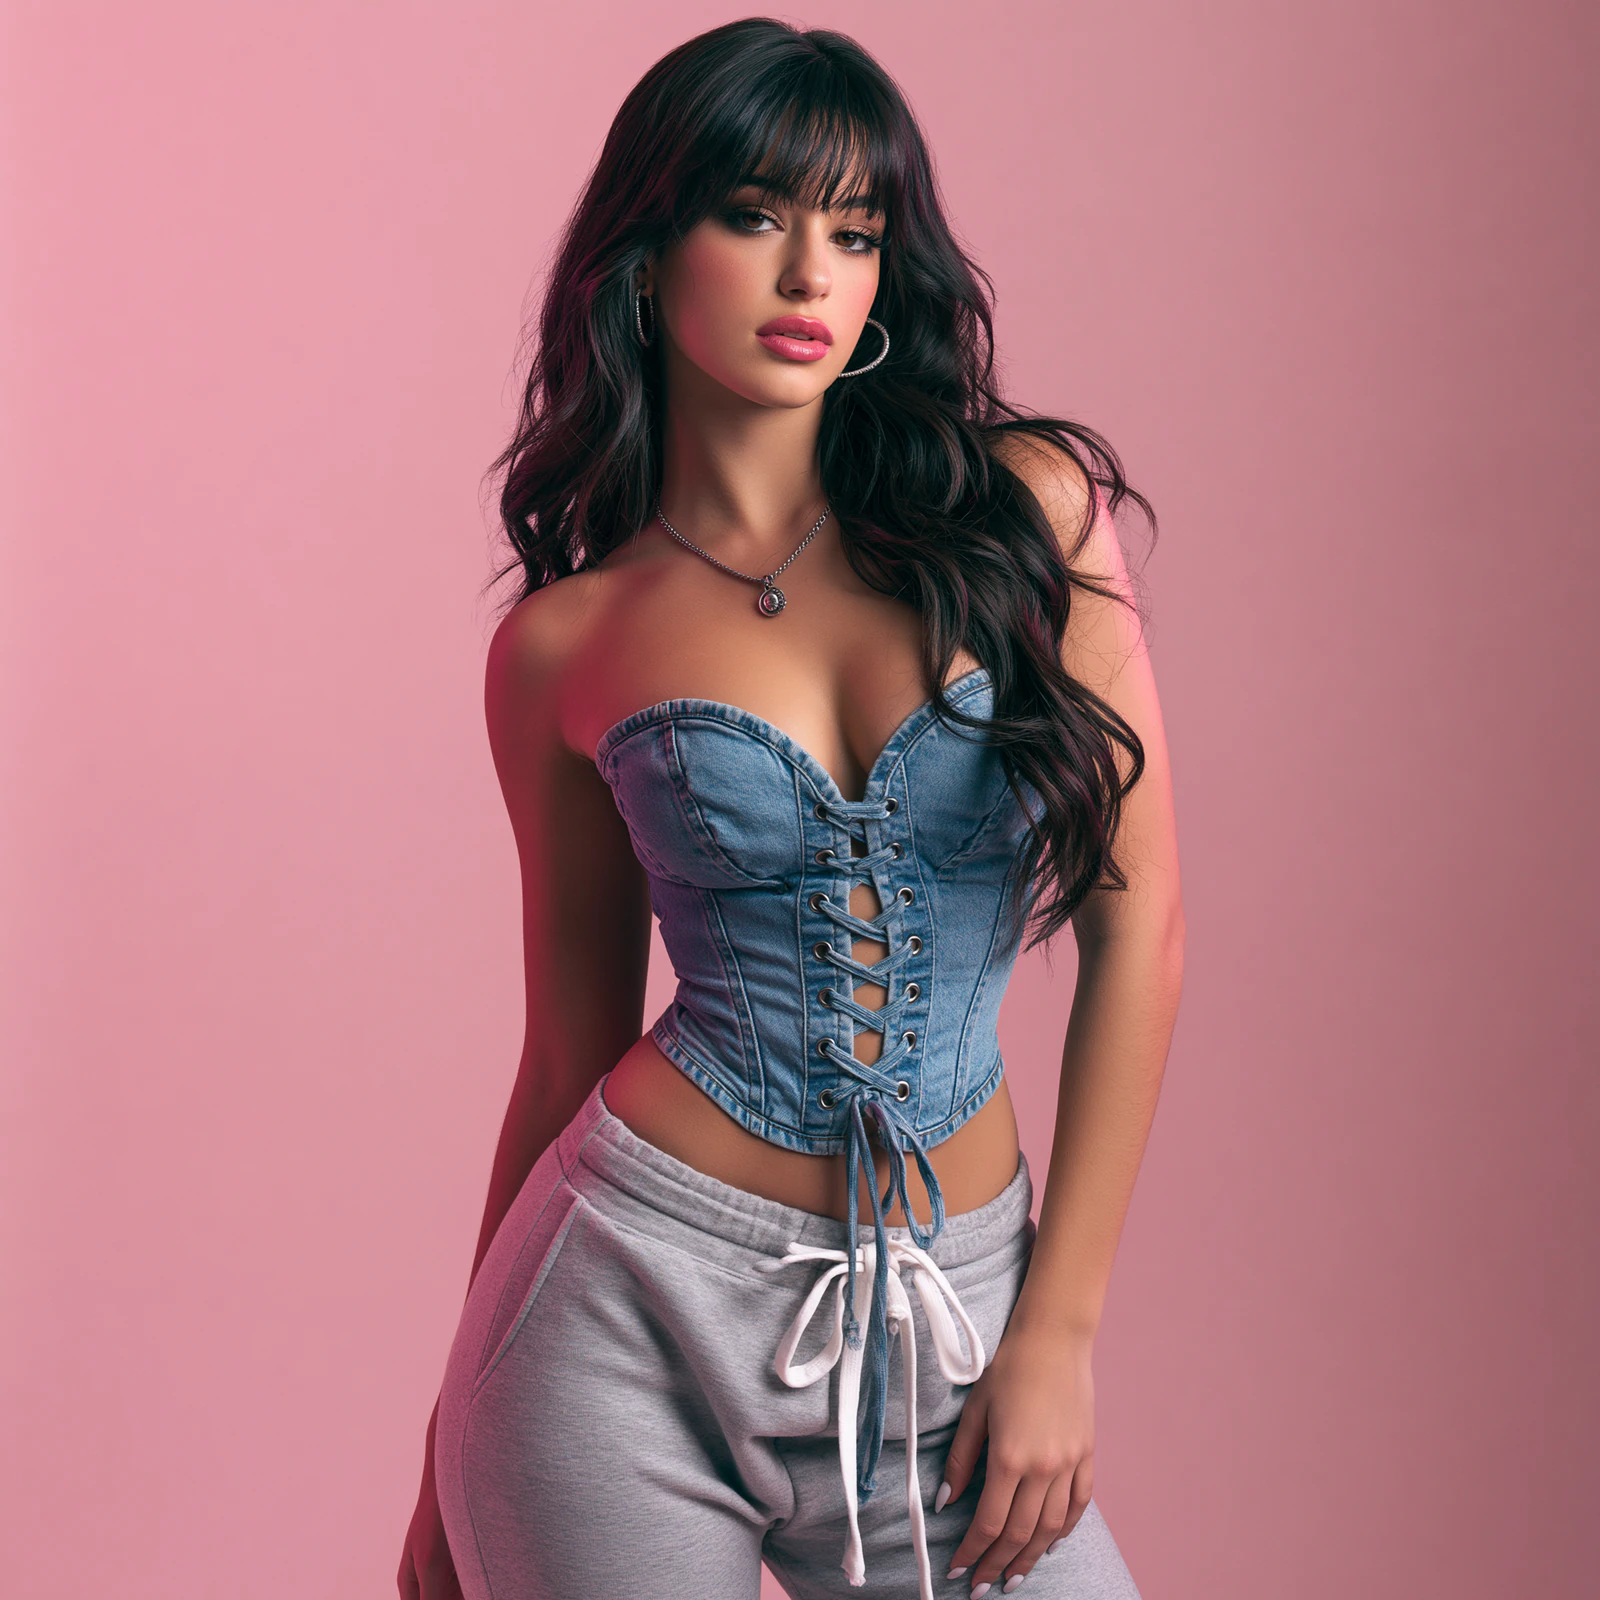
提示詞: Photorealistic portrait of a young woman with long dark wavy hair and bangs, wearing a blue denim corset top with lace-up front and grey sweatpants, large hoop earrings, circular pendant necklace. She stands against a soft pink background, hands in pockets, looking at the camera. Soft, even studio lighting. Shallow depth of field. --ar 3:4 --v 8.1 --s 150 --hd
你看到一張想照著做的圖,缺的只是把它說出來的那些話。傳上來,AI 替你寫:畫面裡有什麼、光怎麼打、怎麼取景、是畫的還是拍的——寫成生圖模型能照著執行的樣子。
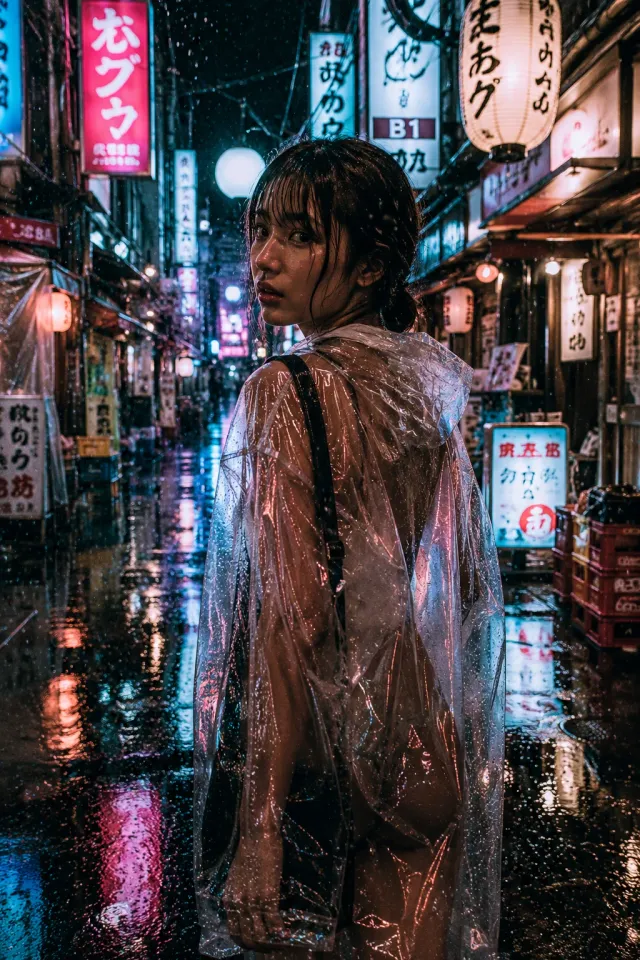
想手寫一個效果,得講清楚材質、光線、鏡頭與情緒,多數人寫到一半就沒詞了。AI 會把這些從你的參考圖裡一條條讀出來寫好。
寫好的提示詞可以直接用在 GPT Image、Midjourney、Flux、Stable Diffusion 與 ComfyUI 裡——貼進去就能照著喜歡的圖做各種變體。手上只有想法、還沒有圖?AI 提示詞產生器從幾個字就能幫你寫出提示詞。
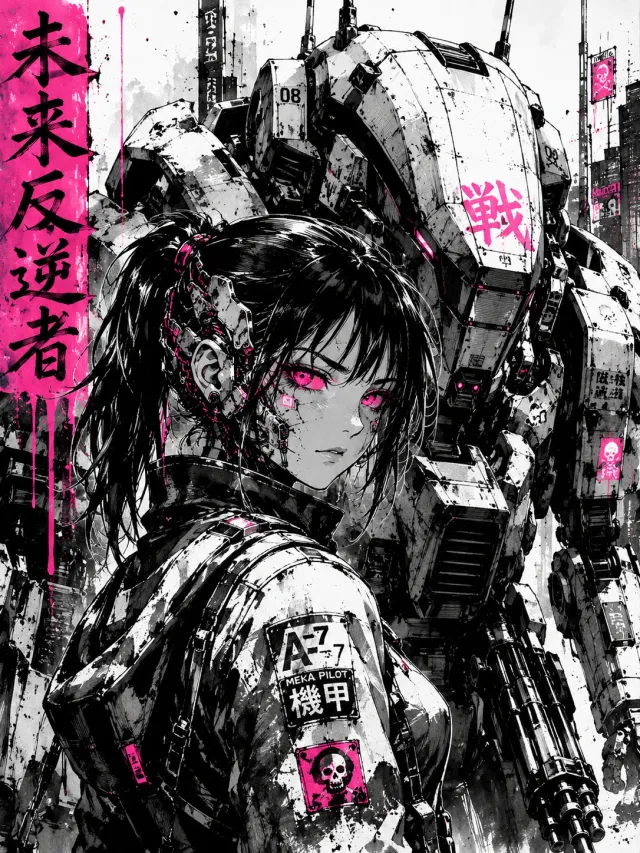
每次上傳都會給你兩條提示詞:一條通用、一條 Midjourney 專用。下面告訴你哪條貼到哪裡。
用 Midjourney 提示詞,不是通用那條。結尾帶著 Midjourney 會讀的參數,版本依你的圖判斷:照片、3D、繪畫用 --v 8.1,動漫、插畫、漫畫用 --niji 7。
用 Midjourney 生成用通用提示詞。裡面沒有任何模型專屬語法,可以直接貼進 Flux、Stable Diffusion XL 或 ComfyUI 的文字節點。Flux 在 Vormly 上就能跑,Stable Diffusion 則貼到你自己的環境裡用。
用 Flux 生成多數同類工具每天只讓你免費擷取幾次。這裡不設這個限制。
沒有每日上限,不扣點數,也沒有付費牆。一整個參考資料夾可以一口氣看完——別的工具一天只給你三到五次。
一次同時給出一條自然語言的通用提示詞與一條 Midjourney 專用的,版本(--v 8.1 或 --niji 7)會依畫風自動判斷。
上傳後幾秒就出結果。帳號是選擇性的,唯一的作用是把你擷取過的紀錄存起來。
圖片在記憶體裡讀完就丟掉,只留下文字提示詞;登入狀態下也只存在你自己的紀錄裡。
提示詞是分塊給的,想改一處不用重寫整段:
只想換個光線,或換個主體?把那一句改掉再生成就行,不用從頭描述整張圖。
只想要配色與構圖,不要提示詞? AI 圖片分析 會給你色碼色票,以及這張圖怎麼打光與取景。
想邊逛邊擷取? 圖片轉提示詞 Chrome 擴充功能 能在任何網站上按一次右鍵,就從那張圖擷取出提示詞。
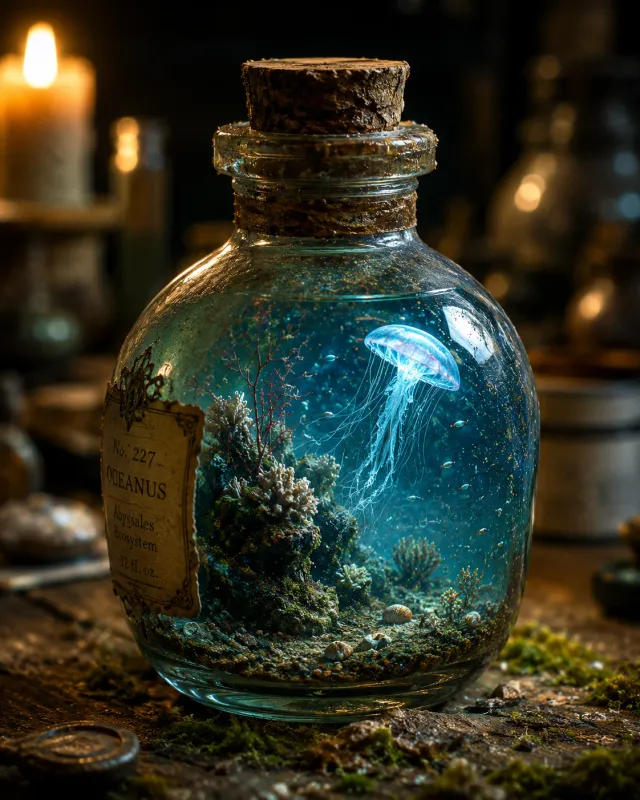
A detailed, photorealistic image of a small glass bottle, sealed with a cork, containing a miniature underwater ecosystem. A bioluminescent jellyfish floats gracefully in the clear blue water...
把 PNG、JPG 或 WebP 拖進來,也可以直接從剪貼簿貼上。
AI 讀一遍這張圖,幾秒就寫好——主體、場景、光線、風格都在裡面。風格不用你選:Midjourney 提示詞會依圖片本身判斷,照片、3D、繪畫帶 --v 8.1,動漫、插畫、漫畫帶 --niji 7。
一鍵複製到你常用的生圖工具,或直接在 Vormly 裡生成。想用自己的語言看懂它?可以翻成另外 18 種語言,英文提示詞會留在旁邊對照。
關於這個工具怎麼讀圖、怎麼寫提示詞。
把圖片傳進這個免費工具就行。AI 會看這張圖的構圖、配色、光線、風格與主體,然後寫成一條詳細的文字提示詞,任何生圖工具都能用。
上傳照片,它會倒推成一條可直接使用的提示詞:讀出主體、場景、顏色、光線與風格,寫成可以貼進 Midjourney、Stable Diffusion、GPT Image 或 Flux 的文字,用來復刻或改寫這個效果。不用自己描述,整個過程自動完成,而且免費。
能。寫出來的提示詞遵循 OpenAI 官方提示指南的結構——背景/場景、主體、關鍵細節、限制條件,可以直接用在 GPT Image 2.0 與 GPT-4o 的影像生成上。
支援,而且是特別調過的。這個模型擅長讀結構清楚、細節豐富的自然語言描述,對構圖、光線與質感的控制很準。我們輸出的正是它最吃得進去的格式:分層的場景描述、明確的材質與顏色、清楚的風格方向,基本不用再調就能出好結果。
可以。自然語言的提示詞適用於 Midjourney v8 以後的版本。想更精準,可以在提示詞後面自己加上 --ar、--v 或 --style 這類參數。
完全免費。不用登入、不用註冊、不用綁卡:傳一張圖,幾秒就拿到提示詞。
不限量。多數同類工具對免費使用者每天只給 3 到 5 次,這裡每天都可以無限擷取。
不會。圖片在記憶體裡讀完,出完提示詞就立刻丟棄,不會存到伺服器,也不會用來訓練模型。登入狀態下保存的只有擷取出來的文字,而且只在你自己的紀錄裡。
圖片提示詞就是你給 AI 繪圖工具的那段文字,告訴它要畫什麼:主體、場景、風格、光線與取景。圖片轉提示詞剛好反過來:你給它一張圖,它替你寫出那段文字,讓你可以重現同樣的效果,或只改其中一部分。
把不對的那部分改掉再用就好。提示詞是分段給的(主體、場景、風格、配色、光線、氛圍、構圖、機位、材質、畫面文字),改一句不用重寫其他部分。如果細節太模糊,換一張更清楚或更大的圖再傳;想問某個特定細節,例如布料到底是什麼材質、招牌上寫什麼,可以用AI 看圖說話直接問。
具體、有結構:先講場景/背景,再講主體與它的實際細節(材質、質感、顏色),接著是光線與機位,最後是限制條件(例如「畫面裡不要有字」)。這個工具會自動照這個結構寫。
能。提示詞不挑模型,Flux(Schnell 與 Dev)、Stable Diffusion XL,以及任何吃自然語言的文生圖模型都適用,在 ComfyUI 的流程裡也好用。
上傳任一張圖,讓 AI 把它背後的提示詞寫出來。
或把檔案拖進來,
也可以直接貼上圖片
支援 PNG、JPG、WebP,可以一次傳多張。