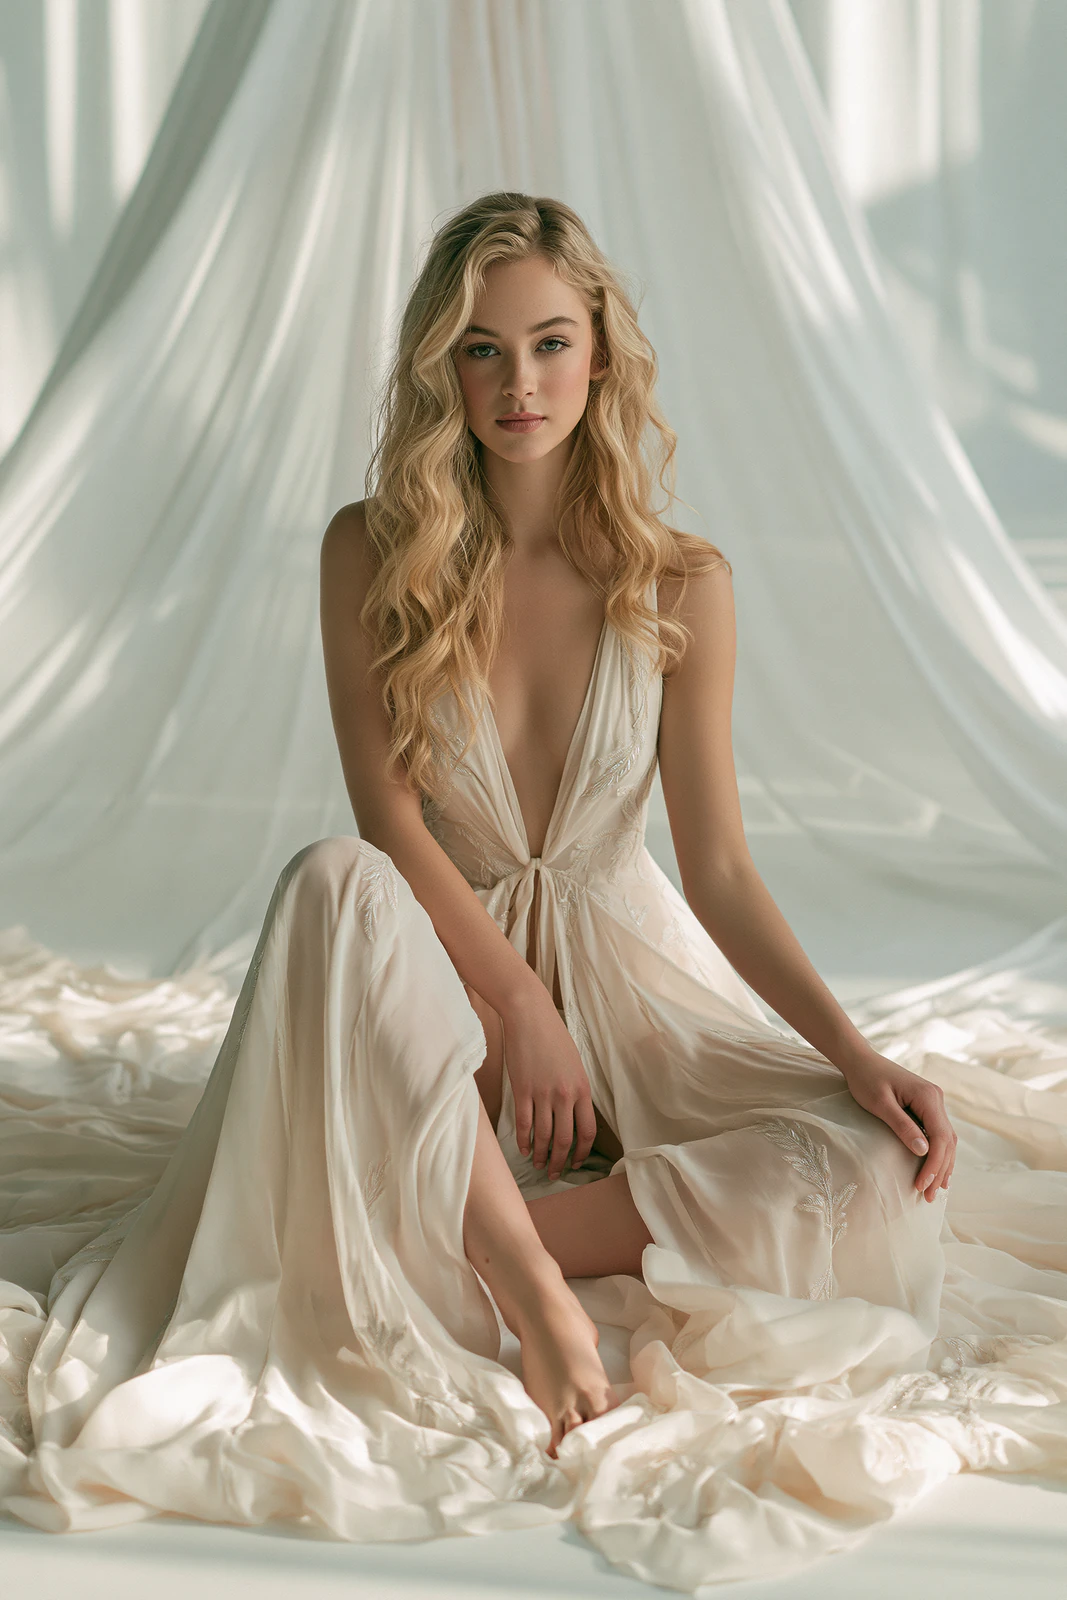
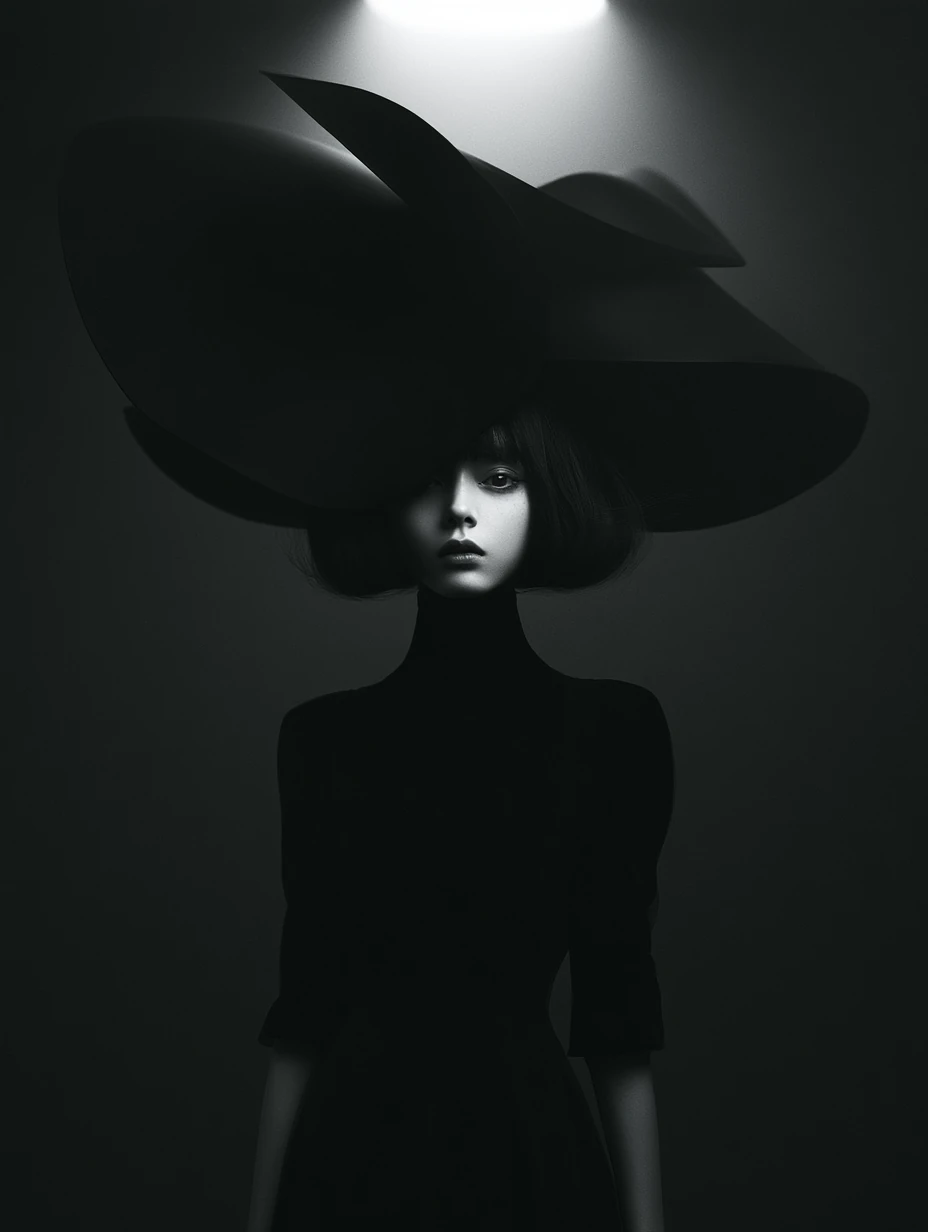
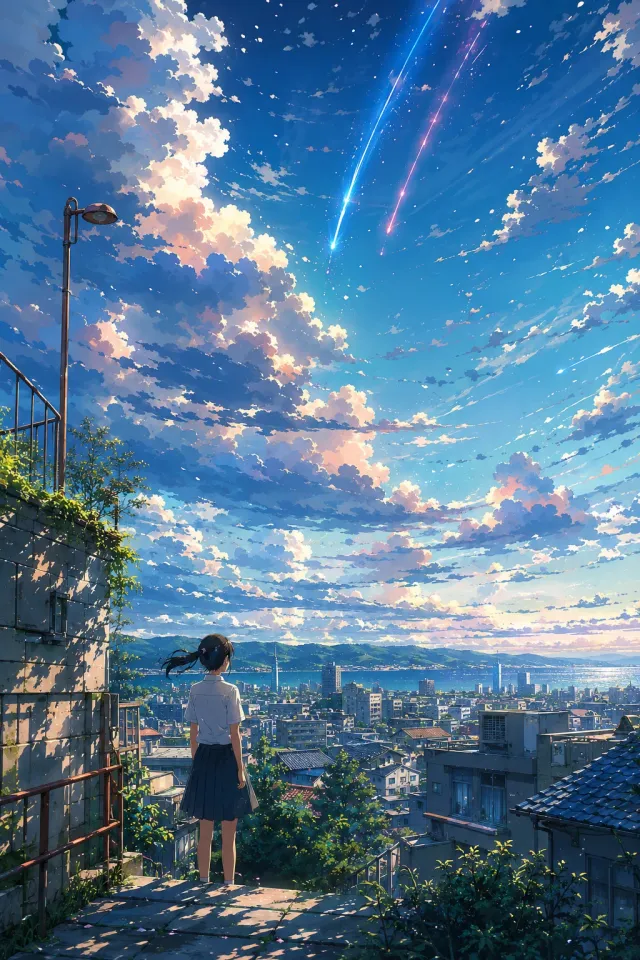
左が元画像、右は抽出したプロンプトで生成したもの。同じツール、レタッチなし。
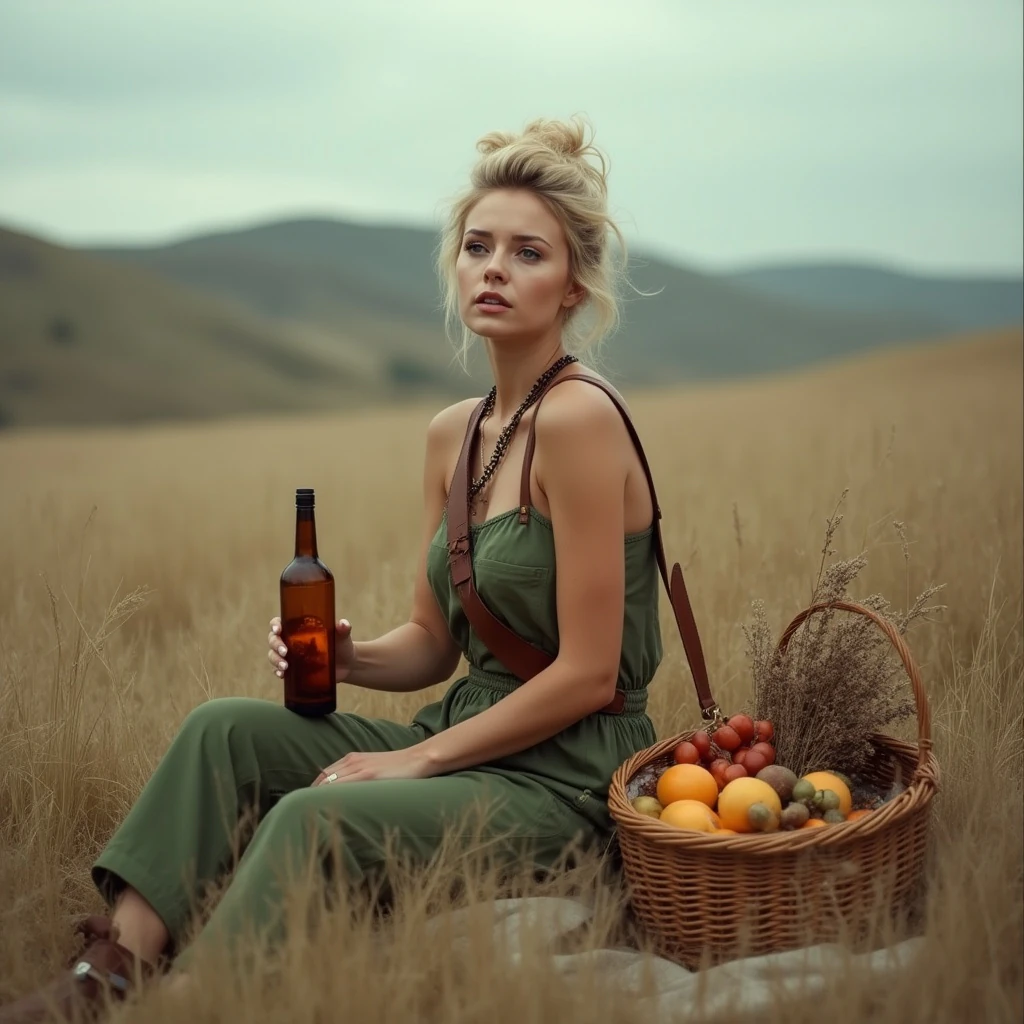
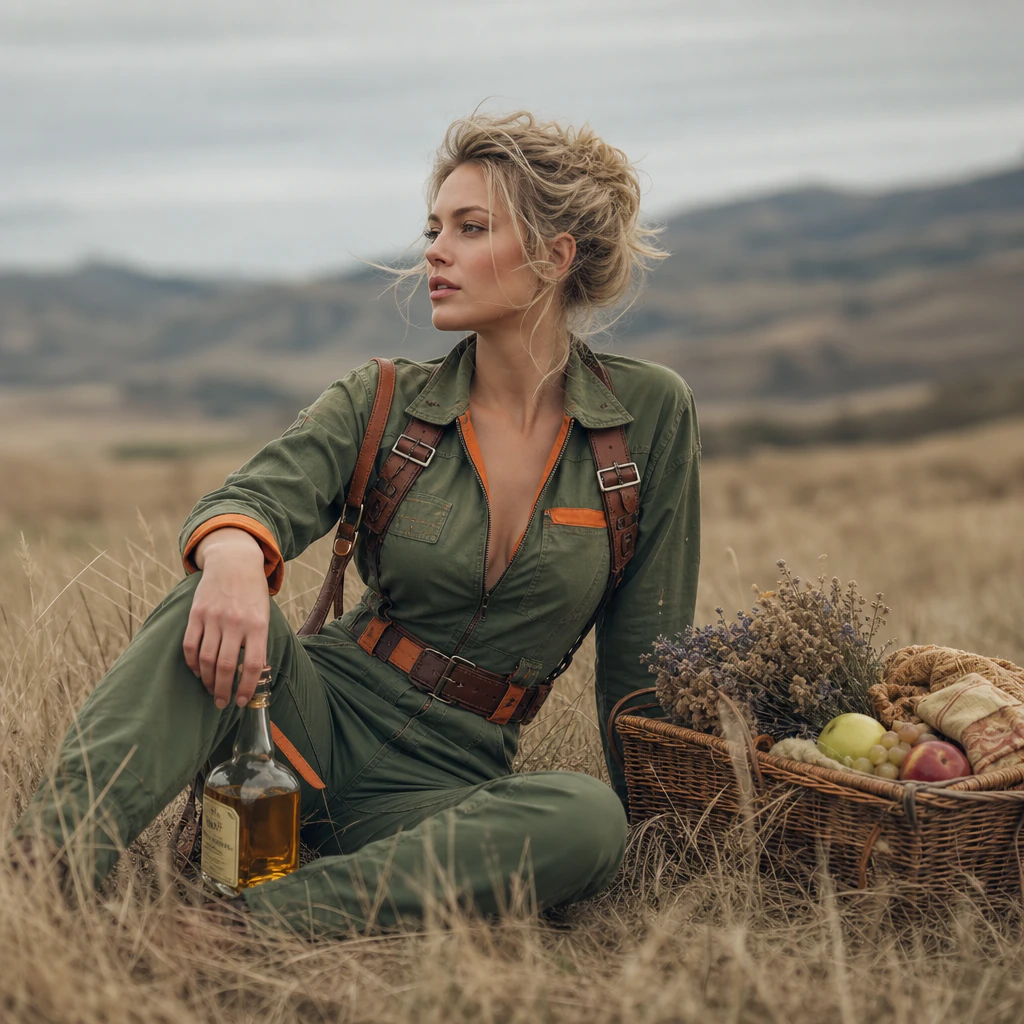
プロンプト: A photorealistic portrait of a woman with blonde, windswept hair styled in an updo, wearing a green jumpsuit with orange accents and a brown leather harness. She is sitting in a field of tall, dry grass, holding a bottle of amber liquid in her right hand and looking off to the side with a thoughtful expression...
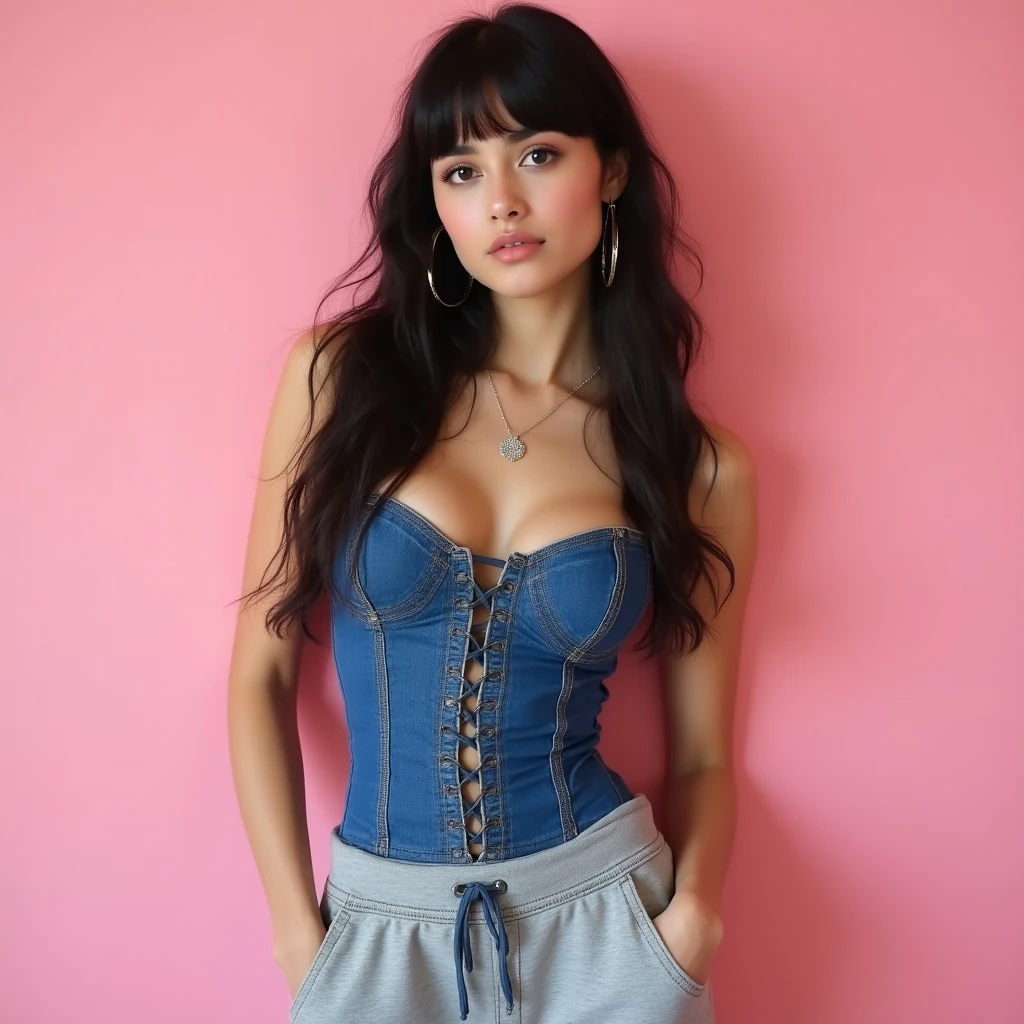
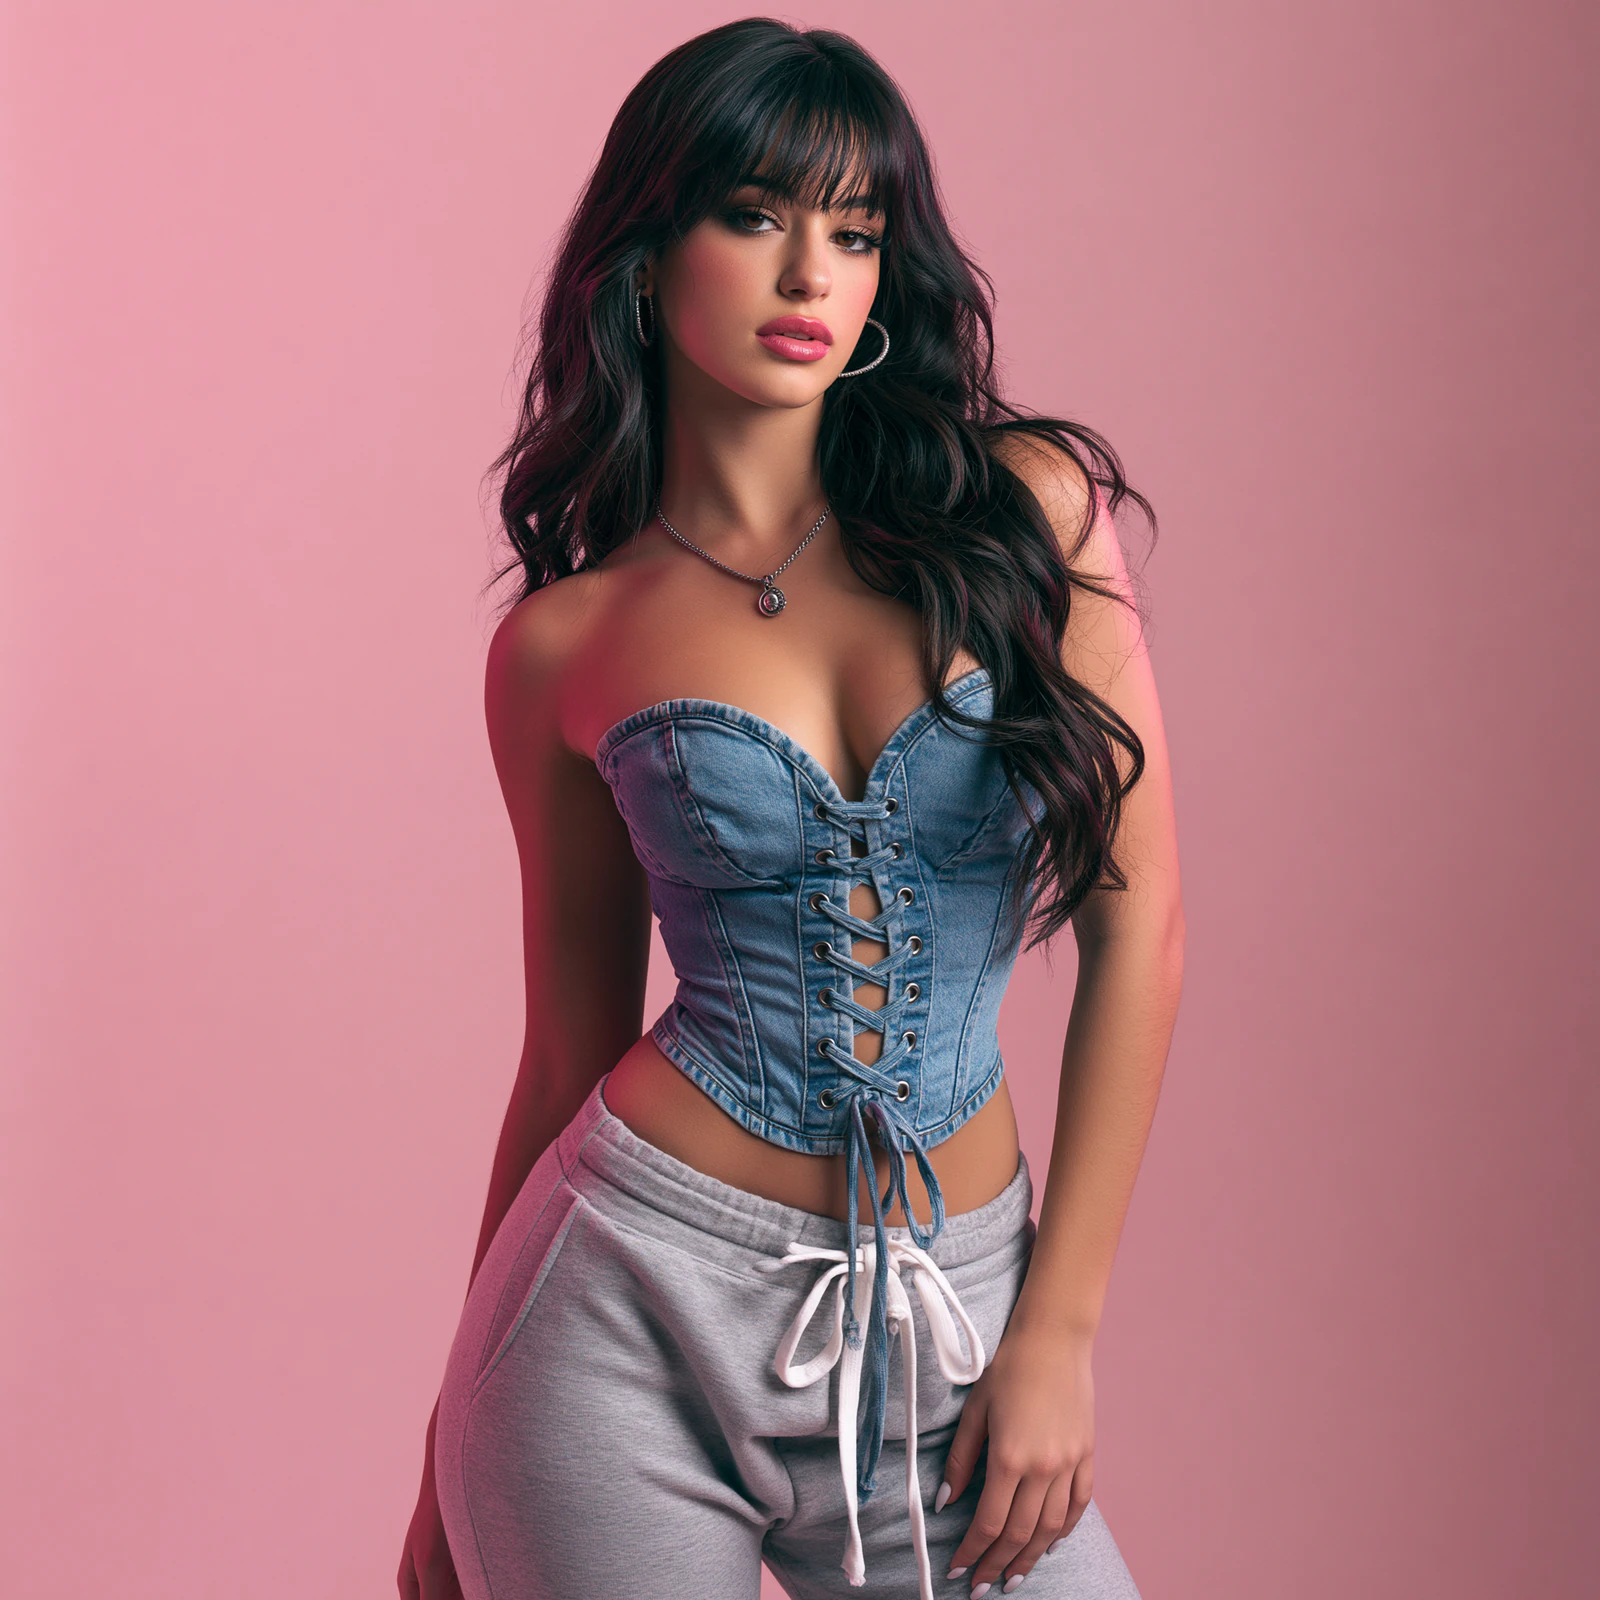
プロンプト: Photorealistic portrait of a young woman with long dark wavy hair and bangs, wearing a blue denim corset top with lace-up front and grey sweatpants, large hoop earrings, circular pendant necklace. She stands against a soft pink background, hands in pockets, looking at the camera. Soft, even studio lighting. Shallow depth of field. --ar 3:4 --v 8.1 --s 150 --hd
こういうものを作りたい、という画像は見つかった。足りないのはそれを言葉にする部分です。アップロードすればAIが書きます。何が写っているか、光の当て方、切り取り方、描かれたものか撮られたものか——画像モデルが従える形で。
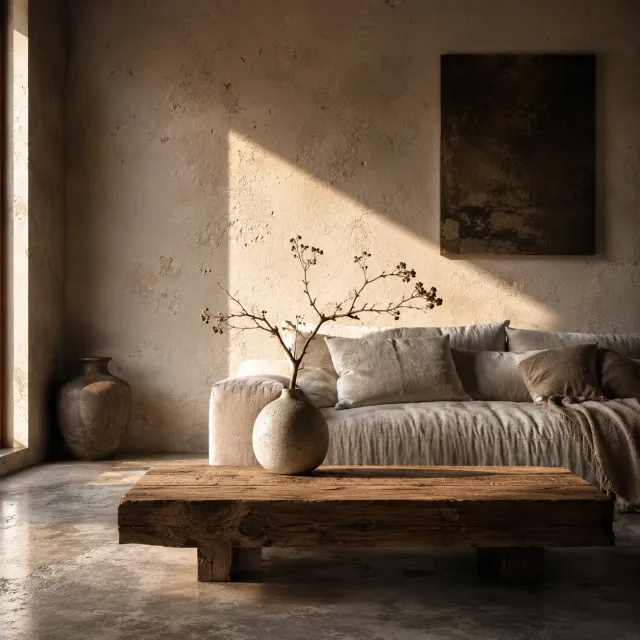
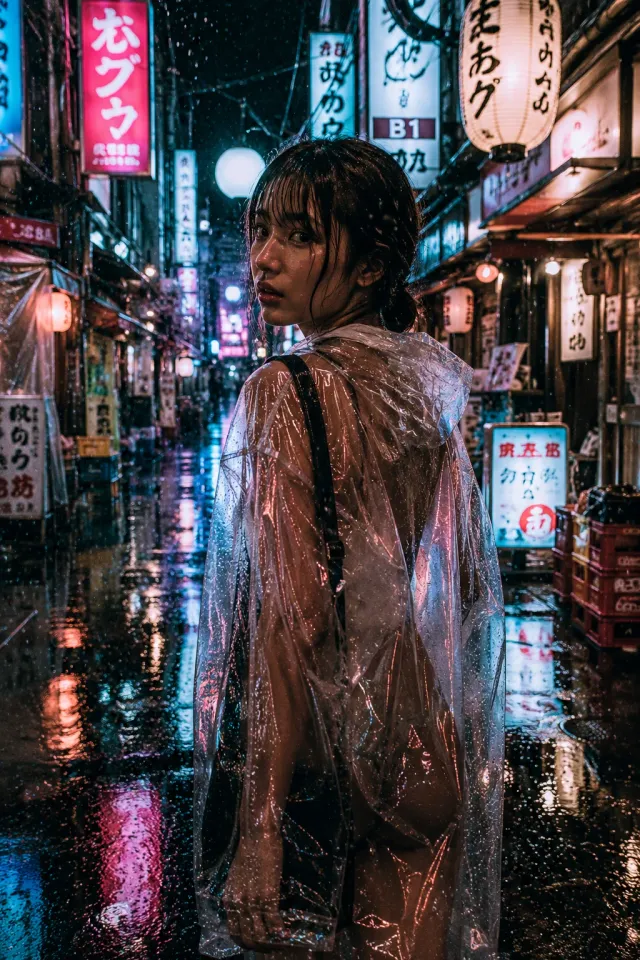
見た目を再現しようとすると、生地、光、レンズ、雰囲気まで言葉にする必要があり、たいてい途中で語彙が尽きます。AIはそれを参考画像から読み取って書き出します。
できたプロンプトは GPT Image、Midjourney、Flux、Stable Diffusion、ComfyUI でそのまま使えます。貼り付ければ、気に入った画像のバリエーションを作り始められます。
多くの同種ツールは1日数回で止まります。ここは止まりません。
1日の上限もクレジットも有料の壁もありません。参考画像のフォルダを一度に片づけられます——他のツールは1日3〜5回で止まります。
自然な文章の汎用プロンプトと、Midjourney 向けのプロンプトを同時に。バージョン(--v 8.1 か --niji 7)は画風から自動判定します。
アップロードすれば数秒で返ります。アカウントは任意で、抽出の履歴が残るだけです。
画像はメモリ上で読まれ、すぐ破棄されます。残るのはテキストだけで、ログイン時も自分の履歴の中だけです。
要素ごとに分かれて返るので、一か所だけ直せます。
光だけ変えたい、被写体だけ入れ替えたい——その一節を書き換えて生成し直すだけです。全部を書き直す必要はありません。
色と構図だけ知りたい、プロンプトは要らない? 画像解析AI ならカラーコードの配色と、光と構図の読み方を返します。
見ているページでそのまま取りたいなら、 画像からプロンプト Chrome拡張 がどのサイトの画像でも右クリック一回で抽出します。
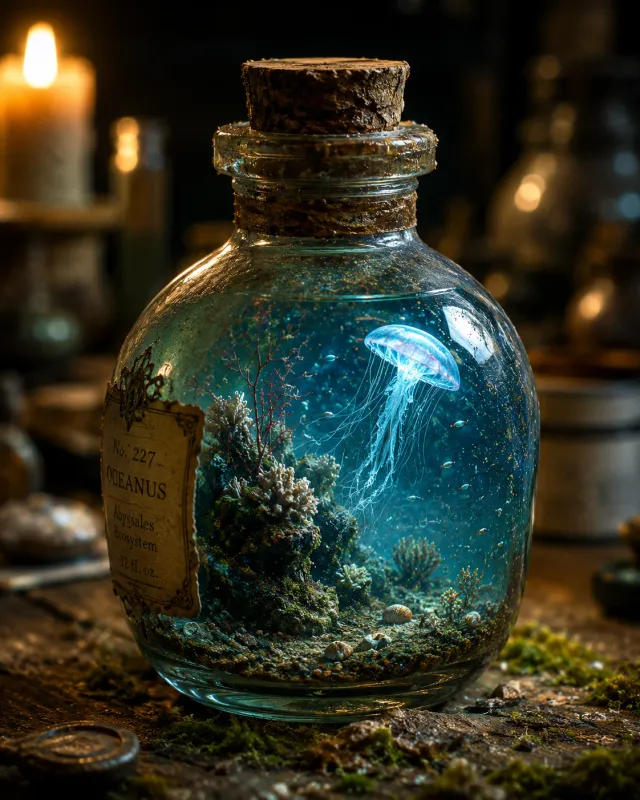
A detailed, photorealistic image of a small glass bottle, sealed with a cork, containing a miniature underwater ecosystem. A bioluminescent jellyfish floats gracefully in the clear blue water...
PNG・JPG・WebP をドラッグ&ドロップ、またはクリップボードから直接貼り付け。
AIが画像を読み、被写体・場所・光・作風を数秒で書き出します。
ワンクリックでコピーして好きな生成ツールへ。Vormly の中でそのまま生成もできます。
画像の読み取りとプロンプトの書き方について。
無料のこのツールに画像をアップロードするだけです。AIが構図・色・ライティング・作風・被写体を読み取り、どの生成ツールでも使える詳しいテキストプロンプトに書き起こします。
写真をアップロードすると、そのまま使えるプロンプトに逆算します。被写体、場所、色、光、作風を読み取り、Midjourney、Stable Diffusion、GPT Image、Flux に貼り付けられる文章にして、その見た目を再現したりアレンジしたりできます。自分で説明する必要はなく、全部自動で、無料です。
使えます。生成されるプロンプトは OpenAI の公式ガイドが推奨する構造——背景/シーン、被写体、主要なディテール、制約——に沿っているので、GPT Image 2.0 や GPT-4o の画像生成でそのまま機能します。
対応しています。というより最適化しています。このモデルは構造がはっきりして情報量の多い自然言語の説明を得意とし、構図・ライティング・質感を細かくコントロールできます。生成されるのはまさにその形式——層になったシーン描写、素材と色の明示、明確な作風指定——なので、そのままで高い再現度が出ます。
もちろんです。自然言語のプロンプトは Midjourney v8 以降で使えます。より狙い通りにするには、生成されたプロンプトのあとに --ar、--v、--style などのパラメータを足してください。
完全に無料です。ログインも登録もクレジットカードも不要。画像をアップロードすれば数秒でプロンプトが返ります。
上限はありません。多くのツールが無料ユーザーを1日3〜5回に制限するなか、ここでは毎日、何枚でも抽出できます。
されません。画像はメモリ上で解析され、プロンプトの生成後すぐ破棄されます。サーバーに保存することも、AIの学習に使うこともありません。ログイン時に保存されるのは抽出されたテキストだけで、あなた自身の履歴の中だけです。
具体的で、構造があるものです。まずシーンや背景、次に主な被写体を具体的なディテール(素材、質感、色)とともに、続いてライティングとカメラアングル、最後に制約(例:「文字を入れない」)。このツールは自動的にこの構造で書きます。
使えます。プロンプトはモデルを選ばず、Flux(Schnell と Dev)、Stable Diffusion XL、自然言語を受け取るどのモデルでも機能します。ComfyUI のワークフローの中でも扱いやすい形です。
画像をアップロードすれば、その裏にあるプロンプトをAIが書き起こします。
ドラッグしても、
クリップボードから貼り付けてもOK
PNG・JPG・WebP 対応。まとめてアップロードできます。