

Pega un enlace de YouTube o sube un clip que guardaste de TikTok, Instagram o tu móvil. Obtén el prompt para volver a hacerlo: un párrafo, una lista de planos escena por escena y un prompt JSON, para Google Flow, Veo 3, Kling, Seedance, Grok o Sora.
MP4, MOV o WebM · hasta 14 MB · hasta 3 minutos
1 video gratis al día sin cuenta
Tres clips y lo que la herramienta devolvió para cada uno, sin editar: el prompt para el modelo de la pestaña y la lista de planos. Los prompts están en inglés, el idioma que leen los modelos de video.
A medium shot of an older Black woman with braided hair, wearing a cozy beige knit cardigan over a white blouse, sitting in a warm, sunlit kitchen. She holds a blue ceramic mug with both hands, steam gently rising from the hot beverage. The background is a soft-focus kitchen with wooden cabinets and a window letting in bright, natural morning light. She speaks with a calm, reflective expression, looking slightly off-camera. "I've been doing this for 30 years. You never really get used to the quiet." Her voice is warm and measured. The scene has a cinematic, soft aesthetic with a shallow depth of field. Audio: ambient kitchen sounds, gentle clinking of a ceramic mug, soft, reflective background music, clear female voice dialogue.
Shot 1 (0:00–0:07) · medium shot Camera: static, eye level, shallow depth of field Subject: an older Black woman with braided hair, wearing a beige knit cardigan over a white blouse Action: she holds a steaming blue mug with both hands and speaks directly to someone off-camera, then smiles Setting: a cozy, sunlit kitchen with wooden cabinets Light: warm, natural morning light from a window, soft highlights Sound: "I've been doing this for 30 years. You never really get used to the quiet." - Woman
208 palabras
Viste un clip y quieres uno igual. La IA mira el video, escucha el sonido y escribe lo que un modelo de video necesita oír para volver a hacerlo.
Quién sale, qué lleva puesto, dónde está, cómo se mueve la cámara, la luz, el ritmo. También escucha el audio: lo que dicen, los efectos de sonido y la música.
Cada corte empieza un plano nuevo con su encuadre, movimiento de cámara y acción, con el segundo exacto, para que puedas rehacer un clip de varios planos uno por uno.
Google Flow necesita que cada plano diga quién sale, Veo 3 el sonido escrito, Kling el movimiento de cámara, Seedance planos numerados y Grok frases cortas. Elige uno y la redacción se adapta.
Cada video te da los tres. Copia el que acepte tu herramienta.
Un párrafo para pegar directamente en Google Flow, Gemini, Veo, Kling, Seedance, Grok, Sora o en el generador de video de aquí. Ideal para clips de un solo plano.
Inicio y fin, encuadre, cámara, sujeto, acción, lugar, luz y sonido de cada plano. Ideal para videos con cortes y para revisar qué vio la IA.
Los mismos detalles en campos: escena, estilo, cámara, iluminación, sujetos, acciones, audio, relación de aspecto. Para herramientas que aceptan prompts JSON o para cambiar un campo y dejar el resto.
El video es el mismo; lo que hay que decirle a cada modelo, no.
Escrito en el orden en que lo lee Flow: cámara, quién, qué hace, dónde, estilo y luego el sonido. Si el clip tiene cortes, cada plano repite quién sale, porque Flow genera cada prompt por separado y si falta la descripción cambia a la persona.
Veo genera sonido, así que el prompt lo dice: los diálogos entre comillas con quién los dice, y luego efectos, ruido de fondo y música en frases aparte.
Empieza por el sujeto y cómo se mueve, y luego la cámara en términos de cine: dolly in, travelling, órbita, grúa. Los diálogos se quitan porque Kling no los pronuncia.
Un clip con cortes se convierte en planos numerados dentro de un solo prompt (Shot 1, Shot 2…), cada uno con su encuadre y movimiento, que es como Seedance arma una secuencia.
Corto y directo: sujeto, acción, lugar, ambiente y cámara en pocas líneas, con el sonido en una frase si importa.
Un párrafo cinematográfico que funciona en Sora, Wan, Hailuo o cualquier otro modelo de video. Pégalo en ChatGPT o Gemini si quieres reformularlo, acortarlo o traducirlo.
Los videos y Shorts de YouTube funcionan con el enlace. TikTok, Instagram y Facebook no dejan que otros sitios lean sus videos: guarda el clip en tu móvil o computadora y súbelo (MP4, MOV o WebM, hasta 14 MB).
Google Flow, Veo 3, Kling, Seedance, Grok Imagine, o Cualquier modelo para Sora y los demás. En unos segundos tienes el prompt, los planos escena por escena y el prompt JSON.
Copia la versión que necesites, cambia lo que quieras (la persona, el lugar, el producto) o pulsa Crear este video para hacerlo aquí mismo.
Dos cosas que conviene saber antes de fiarte del resultado, citadas tal cual de las empresas que hacen los modelos.
La IA ve aproximadamente un fotograma por segundo. En un clip con cortes muy rápidos puede juntar dos planos cortos en uno, así que compara la lista de planos con el video antes de rehacer un montaje.
“This default sampling rate works well for most content, but note that it may miss details in videos with rapid motion or quick scene changes.”Por eso la versión para Veo 3 escribe los diálogos, los efectos y la música en frases separadas en lugar de mezclarlos con la descripción.
“We recommend that you use separate sentences in your prompt to describe the audio.”Enlaces, límites, sonido, precio y qué pasa con tu video.
Con YouTube (videos y Shorts) basta con pegar el enlace. TikTok, Instagram, Facebook y X no dejan que otros sitios lean sus videos, así que guarda el video en tu móvil o computadora y sube el archivo; el resultado es el mismo.
Sube el video o pega su enlace de YouTube, elige el modelo con el que lo vas a recrear y pulsa Sacar prompt. Obtienes un prompt que describe lo que se ve con el detalle suficiente para hacer un video del mismo tipo. Pero nadie puede recuperar las palabras exactas que escribió el autor: el video no las contiene.
Sí. Cada resultado tiene una pestaña JSON: escena, estilo, cámara, iluminación, sujetos, acciones, audio (diálogos, efectos, música), relación de aspecto y duración como campos separados. Pégalo en herramientas que aceptan prompts JSON o cambia un campo y deja el resto.
Sí. Elige Google Flow antes de sacar el prompt. El texto nombra la cámara, la persona, la acción, el lugar, el estilo y el sonido en ese orden, y termina con la relación de aspecto y la duración. Si el clip tiene cortes, recibes un plano numerado por línea que vuelve a describir a la persona, así puedes pegarlos en Flow uno a uno y mantener el mismo personaje. El mismo texto sirve en la herramienta de video de la app de Gemini.
Los archivos pueden pesar hasta 14 MB y durar hasta 3 minutos. Los enlaces de YouTube pueden ser más largos, pero la lista guarda como mucho 12 planos, así que de un video largo sale un resumen. Para un prompt que vayas a reutilizar, recorta los segundos que quieres recrear.
Sí. Los diálogos se escriben entre comillas (traducidos al inglés, con el idioma original indicado), junto con los efectos y la música. Veo 3 y Grok Imagine pueden generar ese sonido; en el prompt para Kling se quitan los diálogos.
Tienes 1 video gratis al día sin cuenta. Después, inicia sesión: cada video cuesta 5 créditos. Si algo falla por nuestra parte, te devolvemos el intento gratis o los créditos.
No. El archivo que subes se borra en cuanto se escribe el prompt. Si iniciaste sesión, se guarda en tus Assets el prompt (no el video) para que lo encuentres después.
Ningún prompt reconstruye un video fotograma a fotograma. Obtienes el mismo tipo de plano: sujeto, lugar, cámara, luz y ritmo. Cuenta con probar un par de veces y ajustar algún detalle.
Los modelos de video siguen mejor los prompts en inglés, así que el prompt siempre está en inglés. Los diálogos se traducen y se indica el idioma original al lado, por si quieres pedirlos en español.
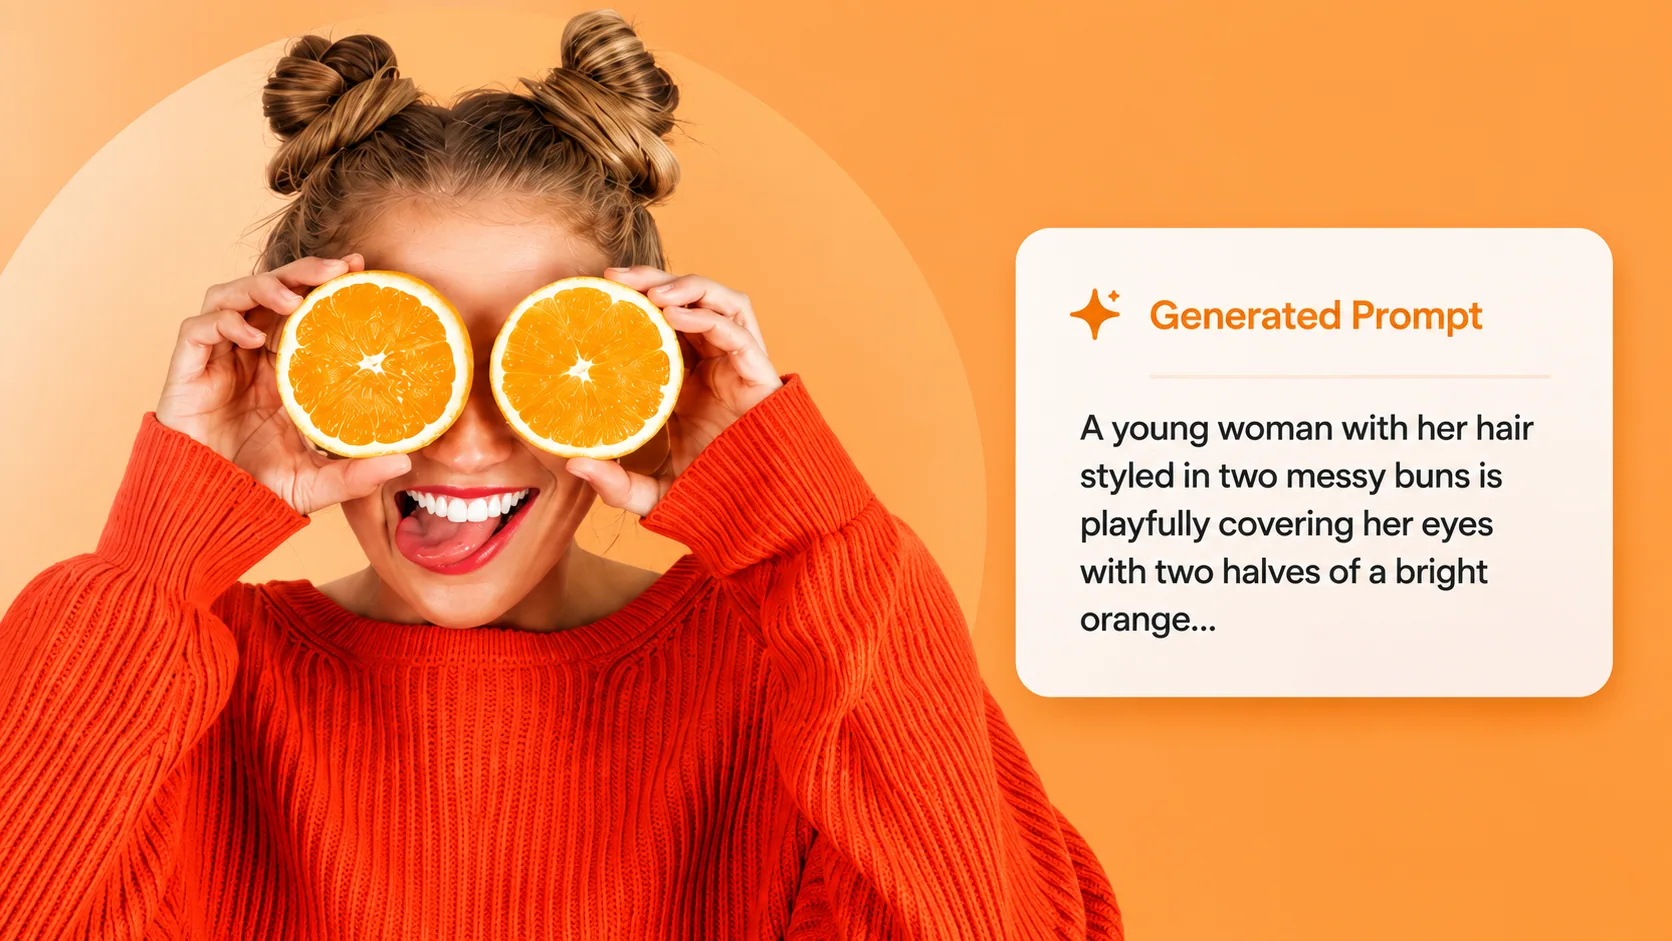
¿Tienes una imagen en vez de un video? Saca el prompt para Midjourney, Nano Banana, GPT Image o Flux de cualquier foto.
¿Ya tienes el prompt? Pégalo aquí y crea el video con Veo, Kling, Seedance o Grok, y cambia lo que quieras.
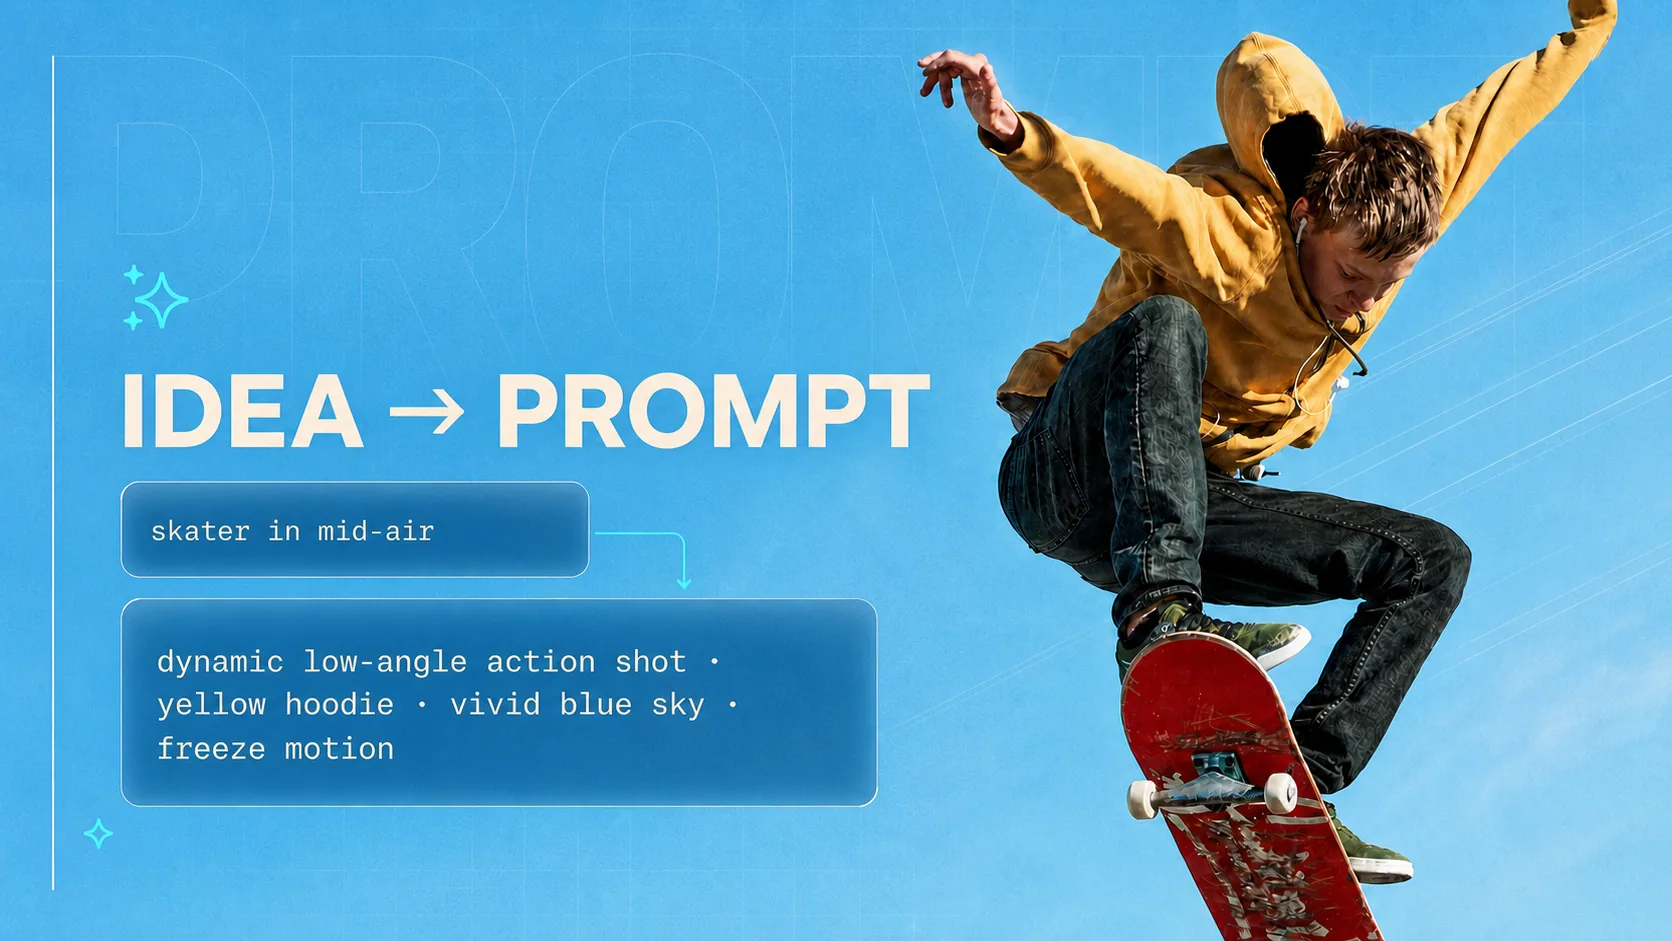
¿Partes de una idea y no de un video? Convierte unas palabras en un prompt detallado para cualquier modelo.